|
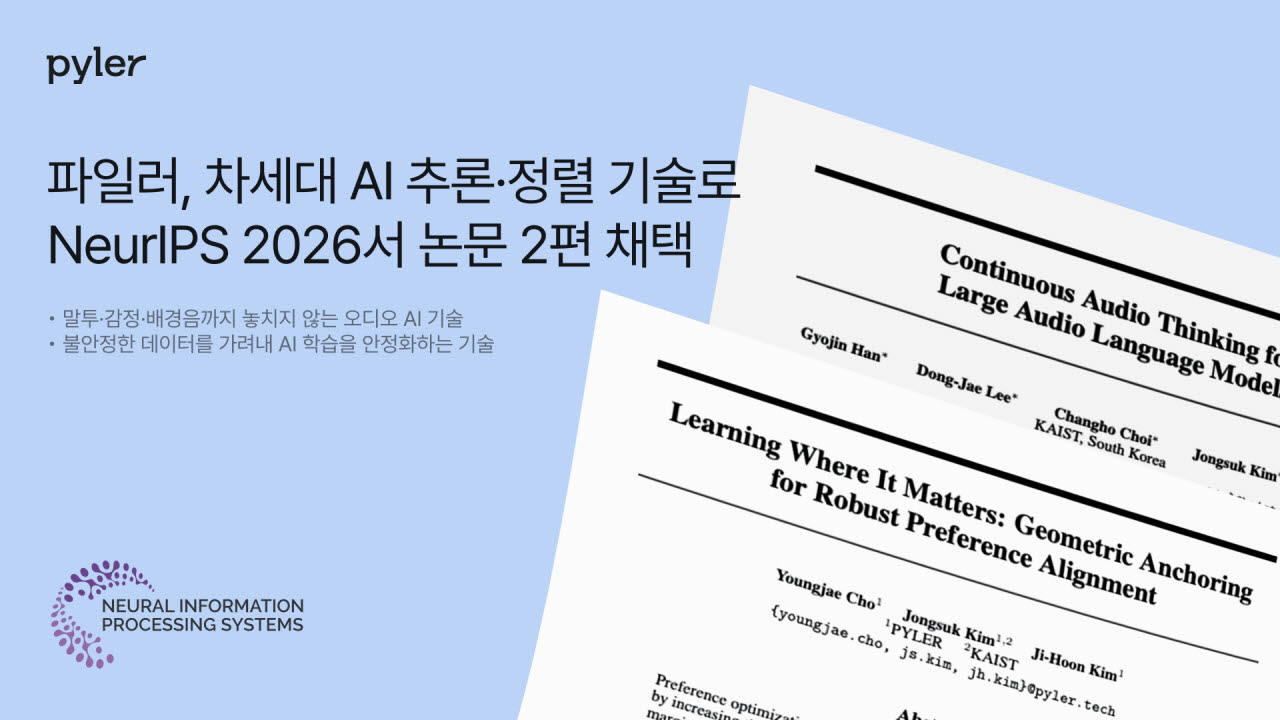
구체적으로 CoAT는 AI가 소리를 이해할 때 목소리의 떨림, 감정, 억양 같은 비언어적 정보까지 사고 과정에 반영하도록 하는 기술이다. 예를 들어 같은 문장이라도 말하는 사람의 목소리나 억양에 따라 전달되는 감정이 달라질 수 있지만, 이를 문자로만 변환하면 이러한 차이를 파악하기 어렵다. 기존의 텍스트 중심 추론 방식 역시 소리가 가진 정보를 충분히 활용하는 데 한계가 있었다. 이를 해결하기 위해 파일러는 AI 내부에 소리 정보를 직접 처리할 수 있는 별도의 ‘생각 공간’을 마련했다. 여기에 음향 복원, 음성 내용, 소리 종류, 감정, 음높이 등 5개 영역의 전문 AI 모델을 활용해 다양한 소리 정보를 학습하도록 설계했다. 특히 소리를 분석하는 과정을 일일이 글로 풀어 쓰지 않고 내부에서 한 번에 처리함으로써 추가적인 텍스트 생성에 따른 시간 부담을 줄인 게 특징이다.
또 다른 논문에서 다룬 GAPO는 AI가 사람의 피드백을 학습할 때 잘못되거나 애매한 데이터에 휘둘리지 않도록 하는 기술이다. 일반적으로 AI는 사람이 더 좋은 답변이라고 평가한 데이터를 학습해 응답의 품질을 개선한다. 그러나 학습 데이터에 오류가 있거나 평가 기준이 일관되지 않으면 ‘답변이 길수록 좋다’는 식의 잘못된 규칙을 학습할 수 있다. 파일러는 이를 개선하기 위해 AI의 판단이 얼마나 쉽게 흔들리는지를 학습 과정에 반영하는 방법을 제안했다. 현재 학습 중인 AI에 작은 변화를 가한 가상의 비교 모델을 만들고, 두 모델의 평가 차이인 ‘앵커 갭’(Anchor Gap)을 측정하는 방식이다. 작은 변화에도 평가 결과가 크게 달라지는 불안정한 데이터에는 낮은 비중을 부여하고, 상대적으로 안정적인 데이터에 집중하도록 설계했다.
이번 학술대회에서 채택된 두 논문은 오는 12월 10일 호주 시드니에서 발표될 예정이다. 시드니 행사에선 주요 연구 발표를 비롯한 워크숍 등의 학술 프로그램이 진행된다.
파일러는 이번 연구를 토대로 영상 콘텐츠의 위험성과 브랜드 적합성을 판단하는 AI 기술을 고도화한다는 계획이다. 김종석 파일러 AI헤드는 “이번 연구는 사람이 소리를 듣고 자연스럽게 구분하지만 글로는 설명하기 어려운 미묘한 정보까지 AI가 이해할 수 있도록 했다는 점에서 의미가 있다”며 “영상의 안전성을 판단할 때는 화면 속 장면뿐 아니라 목소리의 어조와 배경음 등도 중요한 요소가 될 수 있다. 앞으로도 이러한 정보를 놓치지 않고 분석할 수 있도록 관련 기술을 발전시켜 나가겠다”고 말했다.