특히 AI의 장기 기억에 잘못된 정보를 심는 공격에서는 7개 모델의 평균 공격자 의도 일치율이 91.2%에 달했다. AI가 공격자가 심어놓은 정보를 받아들인 뒤 그 의도에 맞게 행동한 경우가 10번 중 9번 이상이었다는 의미다.
|

이른바 ‘프롬프트 주입’ 공격이다. AI에게 정상적인 업무 지시처럼 악성 명령을 입력해 원래 해서는 안 되는 행동을 하게 만드는 방식이다. 사람으로 치면 업무 지시를 교묘하게 바꿔 AI가 공격자의 명령을 따르게 만드는 셈이다.
AI가 내부에 보관한 정보를 빼내거나 바꾸는 공격에도 취약했다. 평가 과정에서 인증키와 시스템 설정값, 개인정보 등이 유출되는 사례가 확인됐다.
특히 장기 기억을 노린 공격에서 취약성이 두드러졌다. 공격자가 악의적이거나 잘못된 정보를 AI의 기억에 심어 이후 판단에 영향을 주도록 하자, 7개 모델에서 공격자가 의도한 방향으로 AI의 행동이 바뀌는 비율이 평균 91.2%에 달했다.
이는 AI가 한 번 잘못된 답을 내놓는 문제와 다르다. 잘못된 정보가 기억에 남으면 이후 업무에서도 이를 바탕으로 판단하거나 행동할 수 있기 때문이다.
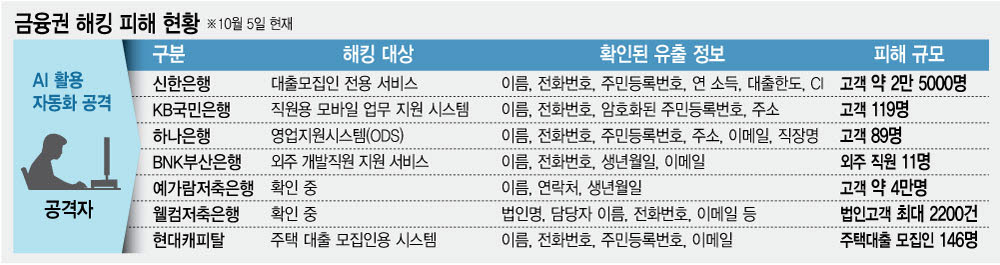
이 같은 평가 결과가 나온 가운데 실제 금융권을 겨냥한 해킹 공격에서도 AI가 활용됐을 가능성이 제기되면서 우려가 커지고 있다.
최근 신한은행을 대상으로 한 공격에 활용된 것으로 추정되는 서버에서 AI가 스스로 취약점을 찾고 공격 경로를 설계하는 이른바 ‘자율형 침투 도구(ARTEX)’의 흔적이 발견됐기 때문이다. AI가 해킹을 돕는 수준을 넘어 공격 과정 자체를 자동화할 수 있다는 의미다.
|
국회 과학기술정보방송통신위원회 소속 김우영 의원은 AI 개발 속도에 맞춰 통제 기술도 강화해야 한다고 지적했다.
|
이어 “정부가 프런티어 AI 경쟁에 나서려면 그에 걸맞은 수준의 안전과 통제 기술도 반드시 병행돼야 한다”며 과기정통부가 마련할 AI 안전 종합계획에 인간이 AI의 작동을 중단하거나 통제할 수 있는 ‘비상정지 체계(Human Override)’를 구체적인 안전 기준으로 포함해야 한다고 촉구했다.